Die überraschendste Anforderung dieser Guideline richtet sich gar nicht an Website-Betreiber, sondern an die Betreiber von Bots: Automatisierte Werkzeuge müssen sich im HTTP-Header als nicht-menschlich zu erkennen geben und Opt-out-Signale beachten. Wer schon einmal Server-Logfiles ausgewertet hat, weiß, warum dieser Satz nötig ist. Ein erheblicher Teil des Datenverkehrs stammt von Maschinen, und ein Teil davon gibt sich als Browser aus. Damit läuft jede Steuerungsmöglichkeit des Betreibers ins Leere, und der Datenverkehr bezahlt er trotzdem.
Die fünf Erfolgskriterien von Guideline 5.19
KI und Datenerhebung: Stelle sicher, dass Datensätze, die von automatisierten Systemen genutzt, erzeugt oder herangezogen werden, nicht größer sind als für die Aufgabe nötig, ethisch beschafft, geprüft, validiert, gespeichert und auf faire, diskriminierungsfreie und verantwortungsvolle Weise verwendet werden.
Anpassung im Unternehmen: Unterstütze Beschäftigte dabei, sich auf neue Technologien einzustellen, die ihre Aufgaben oder die Abläufe der Organisation verändern oder umwälzen können.
Ökologische Verantwortung: Prüfe den Bedarf an KI und neuen oder disruptiven Technologien vor der Einführung, um unnötigen Ressourcenverbrauch zu vermeiden. Optimiere Modelle und Deployment-Prozesse auf Effizienz. Miss, bewerte und bilanziere ihre Umweltwirkungen über den gesamten Lebenszyklus. Beziehe dabei Auswirkungen aus eigenen wie aus fremden Quellen ein und nutze verfügbare Daten oder, wo direkte Daten fehlen, glaubwürdige Schätzungen. Bevorzuge Ansätze, die negative Umweltwirkungen möglichst gering halten.
Automatisierte Werkzeuge: Stelle sicher, dass Bots, Crawler, User Agents, Scraper, künstliche Intelligenz und alle weiteren automatisierten Werkzeuge Opt-out-Signale auf Host-, Server- und Seitenebene beachten. Anbieter müssen sich im User-Agent des HTTP-Headers als nicht-menschlich zu erkennen geben.
Quantenresilienz: Setze Post-Quanten-Verschlüsselung nur dort ein, wo ein klarer Bedarf besteht, um sich gegen Angriffe nach dem Muster „jetzt sammeln, später entschlüsseln“ und gegen langfristige Vertraulichkeitsrisiken zu schützen. Behandle sie als Ergänzung und nicht als Ersatz bestehender Verschlüsselungsverfahren und nutze während einer Umstellung beide. Sei zurückhaltend bei der Einführung in stark frequentierten Diensten, da Bandbreitenverbrauch, Rechenbedarf, Entwurfskomplexität und Migrationsrisiken den Sicherheitsgewinn überwiegen können.
Meine Einordnung
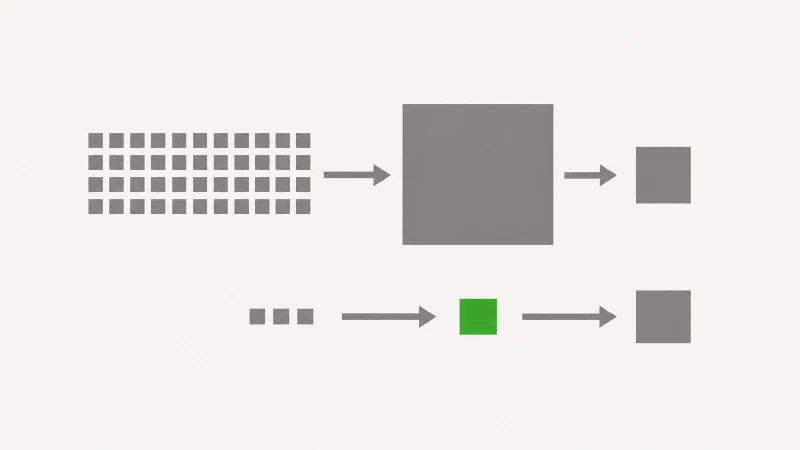
Das erste Kriterium ist Datensparsamkeit, angewendet auf maschinelles Lernen: Datensätze nicht größer als für die Aufgabe nötig. Das steht quer zur verbreiteten Annahme, dass mehr Daten immer besser sind. Und es hat eine direkte Entsprechung bei der Modellwahl. Für die meisten Aufgaben im Redaktionsalltag ist das größte verfügbare Modell nicht das passende, sondern nur das teuerste, und zwar in Energie wie in Kosten.
Das dritte Kriterium wurde zuletzt vollständig neu gefasst, und die Richtung der Änderung finde ich bemerkenswert. Die ältere Fassung setzte bei der Bilanzierung an: Was verbraucht die Technologie, die wir bereits einsetzen, an Abfall, Wasser und Emissionen je Nutzung? Die neue Fassung setzt eine Stufe früher an und fragt zuerst nach dem Bedarf, ausdrücklich vor der Einführung. Erst danach folgen Optimierung, Messung und Bilanzierung über den gesamten Lebenszyklus.
Dass die konkreten Begriffe Wasser und Abfall dabei verschwunden sind, bedaure ich, denn gerade der Wasserverbrauch von Rechenzentren wird selten benannt und trifft oft Standorte, an denen Wasser ohnehin knapp ist. Was der Text dafür gewonnen hat, wiegt schwerer: Die Leitfrage lautet nicht mehr „wie grün ist das Rechenzentrum“, sondern „brauchen wir diesen Aufruf überhaupt“. Und für den Fall, dass belastbare Zahlen fehlen, was bei KI-Diensten eher die Regel als die Ausnahme ist, verlangt das Kriterium ausdrücklich glaubwürdige Schätzungen. Keine Daten zu haben ist damit keine Entschuldigung mehr.
Das fünfte Kriterium ist eine kleine Sensation, weil ein Standard hier ausdrücklich zur Zurückhaltung rät. Post-Quanten-Verfahren arbeiten mit deutlich größeren Schlüsseln, und größere Schlüssel bedeuten mehr Bytes bei jedem Verbindungsaufbau und mehr Rechenaufwand auf beiden Seiten. Bei einem stark frequentierten Dienst summiert sich das. Die Guideline sagt also: Sicherheit ja, aber begründet und nicht als Reflex. Genau dieselbe Abwägung fordere ich bei jeder anderen Technikentscheidung auch.
Wo ich weiter gehe
Ich setze KI zur Recherche und zur Überarbeitung von Texten ein und dokumentiere das in einer KI-Richtlinie auf meiner Website. Transparenz halte ich hier für die Mindestanforderung, und sie ist erstaunlich selten.
Eine brauchbare Richtlinie beantwortet drei Fragen: Wofür wird KI eingesetzt? Wofür ausdrücklich nicht? Und wer prüft das Ergebnis? Die dritte Frage ist die wichtigste. Unüberprüfte Ausgaben erzeugen Fehler, Fehler erzeugen Korrekturen, Rückfragen und Richtigstellungen, und jede dieser Runden verbraucht mehr Ressourcen als die eingesparte Schreibzeit.
Beim Verbrauch ist mir die Guideline mit ihrer neuen Fassung ein gutes Stück entgegengekommen. Ein Rest Skepsis bleibt trotzdem, denn direkt hinter der Bedarfsprüfung steht weiterhin die Optimierung.
Aus Betreibersicht hat das vierte Kriterium noch eine unangenehme Kehrseite, die im Text nicht steht: Du kannst nur den Bots widersprechen, die sich zu erkennen geben. Wer sich als gewöhnlicher Browser tarnt, ignoriert Deine Angaben in der robots.txt und taucht in Deiner Statistik als Besucher auf. Genau deshalb ist die Auswertung der Server-Logfiles hier so wertvoll: Auffällige Muster, etwa viele Abrufe ohne Bilder oder in maschinellem Takt, verraten mehr als jede Kennzeichnung.
Und der Umkehrschluss gilt ebenso: Wer selbst automatisiert Inhalte abruft, sollte sich kennzeichnen und die Regeln anderer beachten. Diese Guideline verpflichtet beide Seiten.
Dein erster Schritt heute
Du brauchst keine KI-Strategie. Du brauchst drei Sätze und einen Blick in die Protokolle.
Auch bei KI gilt der Grundsatz, der für jede andere Anfrage im Netz gilt: Die sparsamste ist die, die nie gestellt wird.
Quelle: W3C-Fassung von Guideline 5.19